
Sadə alt sətir axtarışı uyğunsuzluqdan sonra naxışı bir mövqe sürüşdürür və hər şeyi yenidən müqayisə edir, ona görə pis halda O(n·m) vaxt aparır. Knuth–Morris–Pratt (KMP) alqoritmi mətndə heç vaxt geri qayıtmır: əvvəlcə naxışı təhlil edir, sonra mətni O(n + m) vaxtda bir dəfə keçir. Eyni məsələnin başqa həlli Rabin–Karp alqoritmidir.
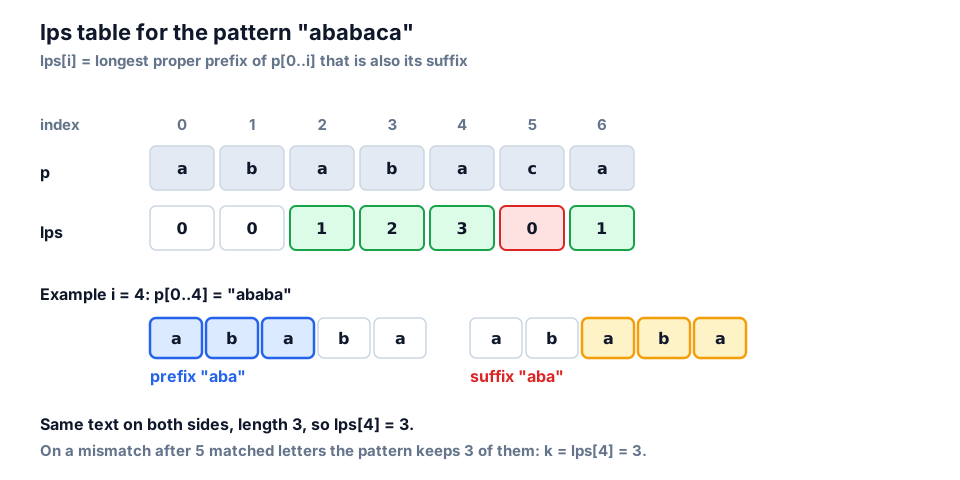
ababaca naxışı üçün lps cədvəliSadə axtarışın problemi
1000 ədəd a mətnində və 50 a + b naxışında sadə alqoritm 950 başlanğıcın hər birində demək olar ki, bütün naxışı yoxlayır.
def naive_count(text, pat):
    cmp = 0
    for i in range(len(text) - len(pat) + 1):
        for j in range(len(pat)):
            cmp += 1
            if text[i + j] != pat[j]:
                break
    return cmp

text = "a" * 1000
pat = "a" * 50 + "b"
print(naive_count(text, pat))48450Prefiks funksiyası (lps)
lps[i] — p[0..i] sətrinin həm prefiks, həm də suffiks olan ən uzun məxsusi prefiksinin uzunluğudur. ababaca üçün cədvəl [0, 0, 1, 2, 3, 0, 1]-dir. O göstərir ki, uyğunsuzluqdan sonra uyğun gələn hərflərin neçəsini saxlamaq olar.
