
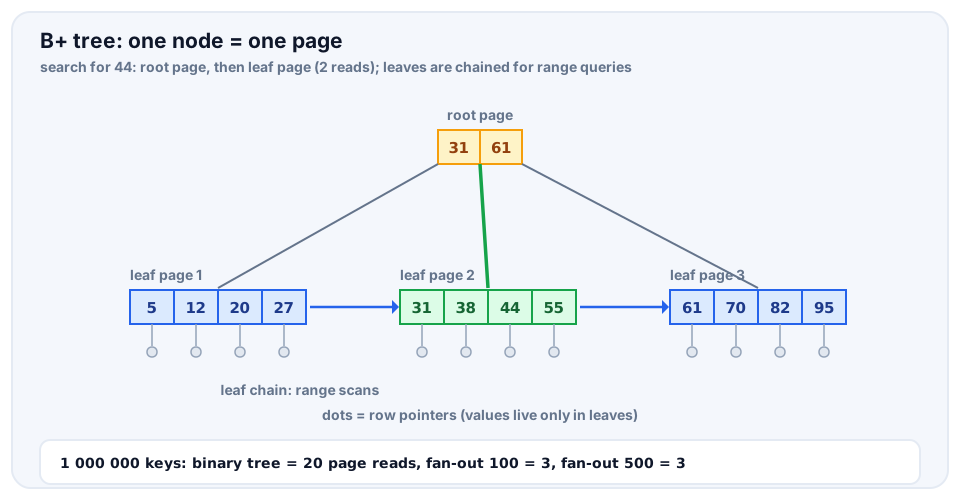
İkili axtarış ağacı yaddaşda yaxşıdır, amma verilənlər diskdə olanda ağacda hər addım bir səhifənin (adətən 8 və ya 16 KB) ayrıca oxunması deməkdir, səhifə oxumaq isə yaddaşa müraciətdən minlərlə dəfə yavaşdır. Bir milyard açar üçün balanslı ikili ağacın təxminən 30 səviyyəsi var, yəni 30 disk oxuması. B-ağac bir düyünə çoxlu açar yığır, beləliklə düyün tam bir səhifəni tutur. Ağac enli və alçaq olur: bir milyard açar üçün bir neçə səviyyə kifayətdir.
Niyə enli ağaclar
Hər səviyyə bir səhifə oxumasına başa gəlir. Düyün fanout yola ayrılırsa, n açar üçün təxminən log_fanout(n) səviyyə lazımdır:
def levels(n, fanout):
    """How many pages must be read to find one of n keys."""
    h, capacity = 0, 1
    while capacity < n:
        capacity *= fanout
        h += 1
    return h

for n in (1_000_000, 1_000_000_000):
    print(n, "binary:", levels(n, 2), "fan-out 100:", levels(n, 100),
"fan-out 500:", levels(n, 500))1000000 binary: 20 fan-out 100: 3 fan-out 500: 3
1000000000 binary: 30 fan-out 100: 5 fan-out 500: 48 KB səhifədə 16 baytlıq (açar və göstərici) təxminən 500 yazı yerləşir, ona görə real fanout bir neçə yüzdür.
Quruluş
Minimum dərəcəsi t olan B-ağac ("tərtib" çox vaxt maksimum uşaq sayı 2t deməkdir):
- hər düyündə
t-1 … 2t-1açar var (kökdə1 … 2t-1), yarpaq deyilsə açardan bir uşaq çox; - düyünün açarları sıralıdır,
i-ci uşağın açarlarıkeys[i-1]iləkeys[i]arasındadır: bu BST-nin ümumiləşməsidir; - bütün yarpaqlar eyni səviyyədədir;
- hündürlük
h ≤ log_t((n+1)/2).
Axtarış kökdən aşağı gedir: düyün daxilində mövqeyi ikili axtarış (bisect_left) tapır, sonra həmin indeksli uşağa keçirik. Qiyməti: O(log n) səhifə oxuması və səhifə başına O(log t) müqayisə.
