
Для двух входов одного и того же размера алгоритм может работать совершенно по-разному. Поэтому, говоря о сложности, нужно уточнять, о каком сценарии идёт речь: лучшем, худшем или среднем.
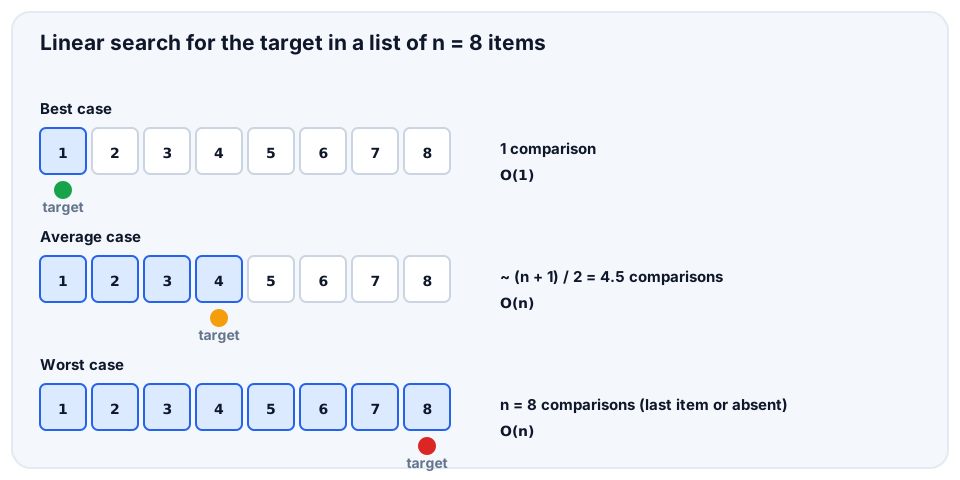
Линейный поиск: три сценария
Возьмём функцию, которая ищет цель в списке слева направо. Если цель — первый элемент, хватит одного сравнения (лучший случай). Если цель последняя или её нет, нужно n сравнений (худший случай). Если считать, что цель с равной вероятностью стоит на любой позиции, в среднем получится (n + 1) / 2 сравнений (средний случай).
def linear_search(a, target):
    comparisons = 0
    for i, x in enumerate(a):
        comparisons += 1
        if x == target:
            return i, comparisons
    return -1, comparisons

a = list(range(1, 11))
print("best   ", linear_search(a, 1))
print("worst  ", linear_search(a, 10))
print("absent ", linear_search(a, 99))
total = sum(linear_search(a, t)[1] for t in a)
print("average", total / len(a))best (0, 1)
worst (9, 10)
absent (-1, 10)
average 5.5