
Поиск подстроки — задача найти все вхождения образца pat в text (n = len(text), m = len(pat)). Наивный способ тратит O(nm). Алгоритм Рабина–Карпа сравнивает окна не по символам, а по скользящему хешу и работает в среднем за O(n + m). О работе со строками: палиндромы и анаграммы.
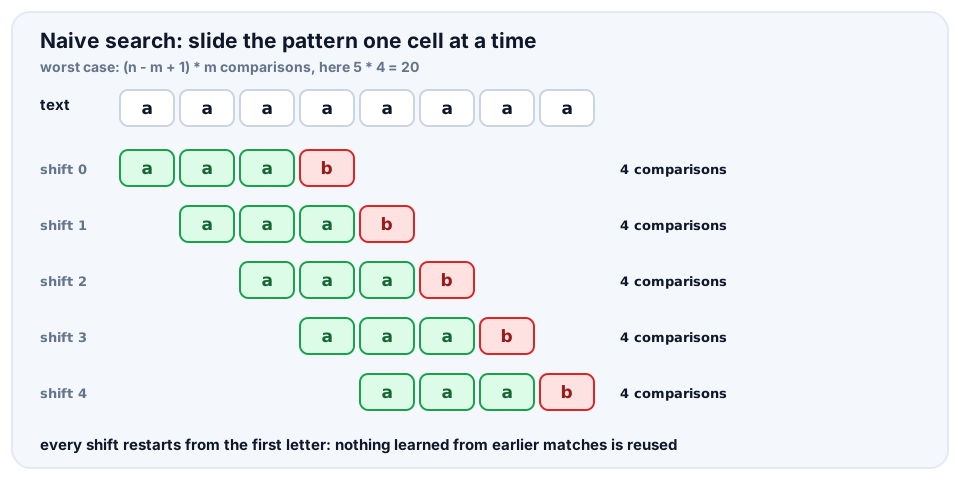
aaab в тексте aaaaaaaa: на каждом сдвиге 4 сравненияНаивный поиск
Прикладываем образец к каждой позиции i (0..n-m) и сравниваем слева направо; при несовпадении сдвигаемся на одну. Позиций n - m + 1, на каждой до m сравнений, значит в худшем случае O(nm). В обычном тексте несовпадение находится в первых символах, и время близко к O(n), но на повторяющихся данных вроде aaaa...ab (ДНК, двоичные тексты) худший случай реален. Память O(1).
def naive(text, pat):
    n, m = len(text), len(pat)
    result, comps = [], 0
    for i in range(n - m + 1):
        j = 0
        while j < m:
            comps += 1
            if text[i + j] != pat[j]:
                break
            j += 1
        if j == m:
            result.append(i)
    return result, comps

print(naive("abracadabra", "abra"))
print(naive("a" * 20, "a" * 9 + "b"))([0, 7], 16)
([], 110)Скользящий хеш
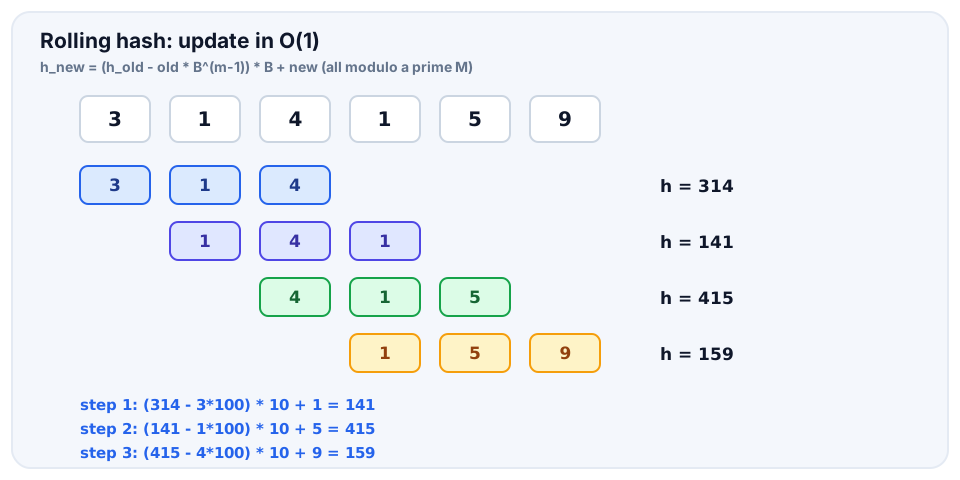
3 1 4 1 5 9: при сдвиге окна обновляется за O(1)Читаем строку как число по основанию B: h(s) = s[0]·B^(m-1) + s[1]·B^(m-2) + ... + s[m-1], храня результат по большому простому модулю M. При сдвиге окна на символ вправо новый хеш получается из старого за O(1): h_new = (h_old - s[i]·B^(m-1))·B + s[i+m] (mod M). Здесь B^(m-1) mod M считается заранее один раз (pow(B, m - 1, M)).
