
Наивный поиск подстроки после несовпадения сдвигает образец на одну позицию и сравнивает всё заново, поэтому в худшем случае работает за O(n·m). Алгоритм Кнута–Морриса–Пратта (КМП) никогда не возвращается по тексту: сначала он разбирает образец, а затем проходит текст один раз за O(n + m). Другой подход к той же задаче — Рабин–Карп.
Проблема наивного поиска
На тексте из 1000 букв a и образце из 50 a и b в конце наивный алгоритм проверяет почти весь образец с каждой из 950 стартовых позиций.
def naive_count(text, pat):
    cmp = 0
    for i in range(len(text) - len(pat) + 1):
        for j in range(len(pat)):
            cmp += 1
            if text[i + j] != pat[j]:
                break
    return cmp

text = "a" * 1000
pat = "a" * 50 + "b"
print(naive_count(text, pat))48450Префикс-функция (lps)
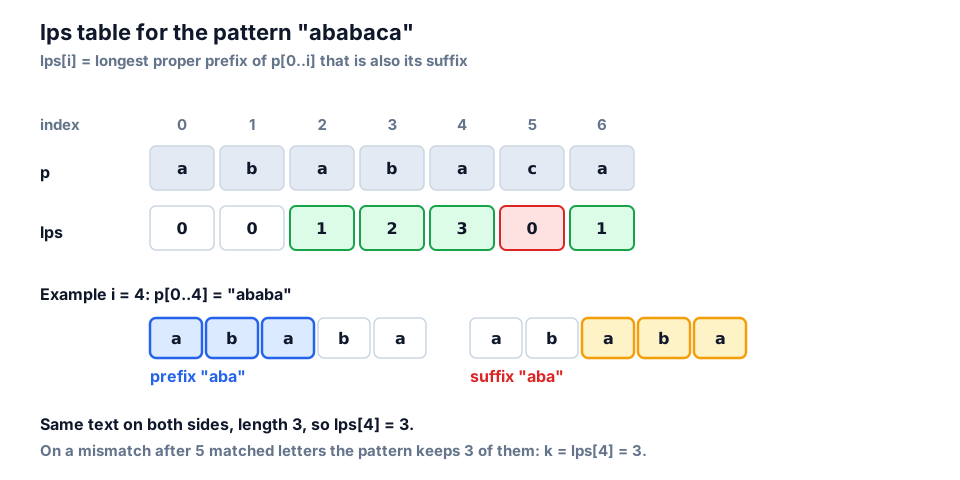
lps[i] — длина самого длинного собственного префикса p[0..i], который одновременно является его суффиксом. Для ababaca таблица такая: [0, 0, 1, 2, 3, 0, 1]. Она говорит, сколько совпавших букв можно сохранить после несовпадения.
