
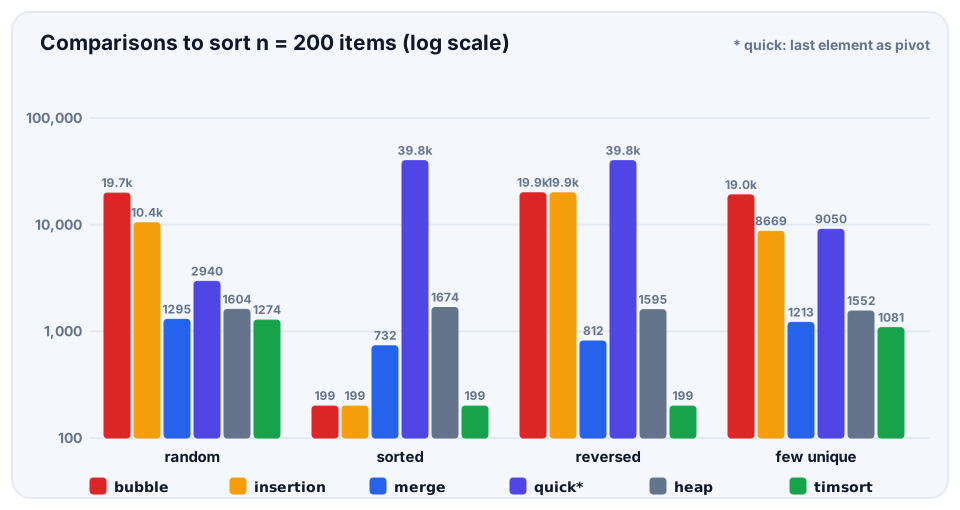
Сравним все написанные сортировки на четырёх видах данных и выведем правила выбора. Мы меряем не секунды, а число сравнений: оно не зависит от компьютера и каждый раз одинаково. Сами сортировки написаны в прошлых уроках: bubble, insertion, merge, quick, heap, Timsort.
Почему считаем, а не меряем
Секунды из timeit зависят от машины, версии Python и нагрузки и меняются от запуска к запуску. Число сравнений — свойство алгоритма. Оборачиваем каждый элемент в класс Key, у которого __lt__ считает вызовы: все сортировки, использующие <, меряются одним счётчиком. Реальное время всё равно стоит проверить отдельно через timeit.
import random, heapq

class Key:
    count = 0
    def __init__(self, v): self.v = v
    def __lt__(self, other):
        Key.count += 1
        return self.v < other.v