
Лейла опубликовала фото и обновила страницу — а фото нет. Через пару секунд оно появилось само. Это не баг приложения, а привет от реплики базы данных, которая немного отстаёт от основной. Серверы приложения мы размножать умеем, чтения кешируем, но база остаётся одна. Разберём, как её масштабировать: в каком порядке действовать, как работают реплики чтения и почему у них бывает лаг, чем партиционирование отличается от шардирования, как выбирать ключ шардирования и зачем нужен PgBouncer.
Сначала простое: лестница масштабирования базы
Каждая следующая ступень сложнее и дороже предыдущей, поэтому на неё поднимаются, только когда нижняя исчерпана:
- Измерить и починить запросы.
EXPLAIN ANALYZE,pg_stat_statements, индексы (урок «Как работают индексы: B-tree и CREATE INDEX»), устранение N+1. - Кеш (прошлый урок): снимает основную часть чтений.
- Мощнее сервер (вертикальное масштабирование): просто и часто достаточно.
- Реплики чтения и пул соединений.
- Партиционирование больших таблиц.
- Шардирование — последним.
Цифры Prowid Photos: метаданные фото — около 36 ГБ в год (расчёт из первого урока), с лайками и комментариями порядка 100 ГБ. Если пользователь оставляет в день ещё около 5 лайков и комментариев, это ≈ 60 записей в секунду в среднем и ≈ 200 в пике. Один PostgreSQL выдерживает такое с большим запасом: шардирование сегодня не нужно, а реплики пригодятся ради отказоустойчивости и разгрузки чтений. Но представьте рост в 100 раз:
| Сегодня | Рост ×100 | |
|---|---|---|
| Активные пользователи | 1 млн | 100 млн |
| Пик API | 350 RPS | 35 000 RPS |
| Метаданные в год | ≈ 100 ГБ | ≈ 10 ТБ |
| Запись в пике | ≈ 200/с | ≈ 20 000/с |
Здесь один сервер уже на пределе по записи и объёму, и шардирование становится честным разговором.
Реплики чтения
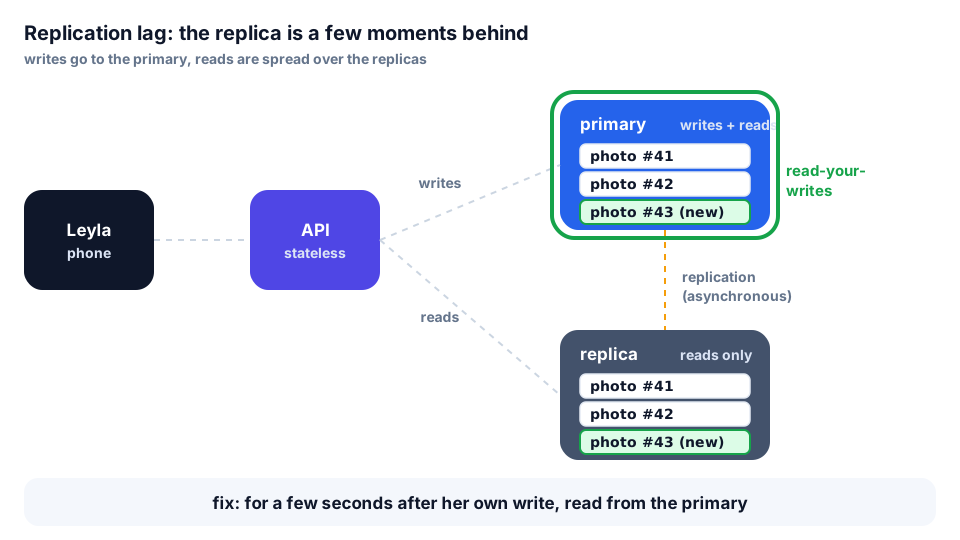
Чтений в Prowid Photos в сто раз больше, чем записей, — идеальный случай для реплик. Primary (он же leader) принимает все записи. Реплики (followers) получают поток изменений и отвечают на чтения. В PostgreSQL это потоковая репликация журнала предзаписи (WAL). Репликация бывает двух видов:
- Асинхронная (по умолчанию): primary подтверждает запись, не дожидаясь реплики. Быстро, но реплика отстаёт, а при аварии primary последние подтверждённые записи могут пропасть.
- Синхронная (
synchronous_standby_names): primary ждёт подтверждения реплики. Данные не теряются, но запись медленнее, а упавшая реплика может остановить запись.
Реплики масштабируют чтение, но не запись и не объём: каждая хранит полную копию. И реплика — не резервная копия: команда DROP TABLE разойдётся по репликам мгновенно. В приложении достаточно двух пулов соединений (то же умеет расширение Prisma @prisma/extension-read-replicas с методами $primary() и $replica()):
import pg from 'pg';

const { Pool } = pg;

const primary = new Pool({ connectionString: process.env.PRIMARY_URL });
const replica = new Pool({ connectionString: process.env.REPLICA_URL });

export const db = {
  write: (sql, params) => primary.query(sql, params),
  read: (sql, params) => replica.query(sql, params),
};