
Три часа ночи: пользователи пишут, что лента Prowid Photos тормозит. Дашборд показывает, что процессор в норме и серверы живы. Где искать причину? Наблюдаемость (observability) — это умение понять, что происходит внутри системы, по тому, что она выдаёт наружу. В этом уроке разберём три вида сигналов — логи, метрики и трейсы, методы RED и USE, цели SLI, SLO и бюджет ошибок, а ещё научимся ставить алерты, которые будят по делу.
Зачем нужна наблюдаемость
Мониторинг отвечает на вопросы, которые вы придумали заранее: «процессор выше 80%?». Наблюдаемость позволяет задать вопрос, о котором вы не подумали: «почему лента медленная только у пользователей из Баку и только в вечерние часы?». После перехода к нескольким сервисам (прошлые уроки) это жизненно важно: один запрос проходит через пять процессов, и «посмотреть логи сервера» уже не работает.
Аналогия — врач. Метрики — это температура и давление: быстро видно, что с пациентом что-то не так. Трейсы — снимок, показывающий, в каком органе проблема. Логи — история болезни: что именно произошло и когда.
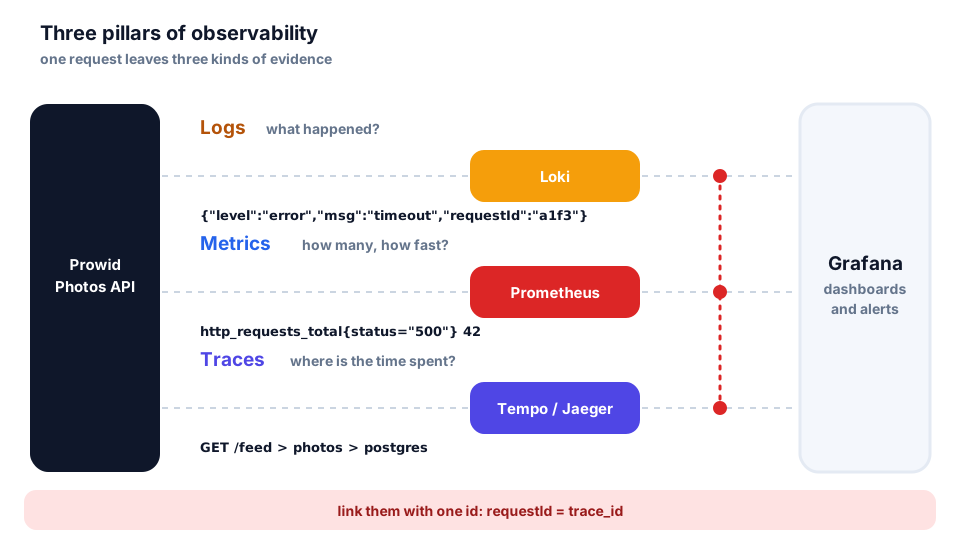
| Отвечает на вопрос | Что это | Цена | |
|---|---|---|---|
| Логи | что именно случилось? | события с подробностями | много места; дорогой поиск |
| Метрики | сколько и как быстро? | числа во времени | дёшево, но без деталей |
| Трейсы | где потерялось время? | путь одного запроса | детальны, поэтому берут выборку |
Типичное расследование: метрика показала, что p95 ленты вырос с 300 до 900 мс (симптом); трейс одного медленного запроса указал на медленный вызов уведомлений (место); лог этого вызова объяснил почему (причина).
Логи: структурированные и с id
Строка console.log('error ' + err) читается человеком, но не поиском: попробуйте найти все ошибки одного пользователя за час. Структурированный лог — это JSON с полями, по которым можно фильтровать. Уровни (debug, info, warn, error) позволяют в продакшене писать только важное. Библиотека pino (вы встречали её в уроке о логировании в Next.js) пишет по JSON-объекту на строку.
Главная находка — correlation id (id запроса): уникальный идентификатор, который попадает в каждую строку лога этого запроса, передаётся другим сервисам в заголовке x-request-id и возвращается клиенту. Теперь по одному id вы соберёте историю запроса со всех сервисов.
import pino from 'pino';
import { randomUUID } from 'node:crypto';

export const logger = pino({
  level: process.env.LOG_LEVEL ?? 'info',
  base: { service: 'prowid-api' },
  redact: ['req.headers.authorization', 'password'], // never log secrets
});

export function requestId(req, res, next) {
  const id = req.get('x-request-id') ?? randomUUID(); // reuse the caller's id
  req.log = logger.child({ requestId: id }); // every line carries the id
  res.set('x-request-id', id); // the client can quote it in a bug report
  const started = Date.now();
  res.on('finish', () => {
    const ms = Date.now() - started;
    req.log.info({ status: res.statusCode, ms }, 'request done');
  });
  next();
}
Строка лога получится такой (pino по умолчанию записывает уровень числом: 30 — это info):
