
Когда компания вырастает из одного кабинета в распределённую корпорацию с филиалами, центрами обработки данных и облачными сервисами, построить надёжную сеть простой закупкой мощных маршрутизаторов невозможно. Сетевой архитектор выступает главным связующим звеном между советом директоров и инженерной группой: он переводит абстрактные бизнес-цели компании (доступность сервисов, финансовый бюджет, непрерывность операций и соответствие международным стандартам) в строгие технические спецификации топологии, протоколов и резервирования. Разберём методологию жизненного цикла сети Cisco PPDIOO, сопоставим подход «сверху вниз» (Top-Down) с подходом «снизу вверх» (Bottom-Up), научимся вычислять доступность и допустимый простой по формуле SLA, а также настраивать зонды Cisco IP SLA для подтверждения проектных метрик.
Цель и что нужно знать
После урока вы сможете:
- сформулировать фундаментальные отличия роли сетевого архитектора от системного администратора и сетевого инженера эксплуатации;
- описать назначение и результаты каждой из шести фаз жизненного цикла сети Cisco PPDIOO (
Prepare,Plan,Design,Implement,Operate,Optimize); - перевести бизнес-требования (доступность, RTO, RPO, регуляторный комплаенс, бюджет CAPEX и OPEX) в технические метрики сети (MTBF, MTTR, задержка, джиттер, потери пакетов, переподписка);
- рассчитать допустимое суммарное время простоя (Downtime) для уровней доступности
99.9%,99.99%и99.999%(«пять девяток») и оценить финансовый ущерб от сбоев; - провести аудит существующей инфраструктуры методом Top-Down, составить матрицу трафика приложений и зафиксировать архитектурные ограничения проекта;
- сконфигурировать зонды Cisco IP SLA UDP Jitter и проверить соответствие параметров задержки и потерь проектным спецификациям в Cisco IOS XE.
Что нужно знать заранее: базовые концепции сетей в объёме курса ccna — стек протоколов TCP/IP, адресацию IPv4/IPv6, принципы маршрутизации и коммутации, метрики задержки (Latency) и пропускной способности (Bandwidth).
Задача из жизни
Крупный коммерческий банк в Баку запускает платформу мобильного банкинга и процессинга пластиковых карт реального времени. На совете директоров председатель правления формулирует задачу: «Платформа платежей критична для нашего бизнеса. Клиенты не должны сталкиваться с отказами при переводах, простой в случае любой аварии не должен превышать пяти минут, утечка или потеря хотя бы одной финансовой транзакции недопустима, а проект обязан строго соответствовать стандарту безопасности PCI-DSS 4.0».
Менеджер инфраструктуры предлагает простое решение: «Давайте закупим самые дорогие флагманские коммутаторы для серверной и арендуем два одинаковых интернет-канала у разных провайдеров».
Через три месяца после запуска экскаватор при дорожных работах перерезает магистральный коллектор, где по случайности проходили кабели обоих провайдеров, а протокол маршрутизации перестраивается дольше двух минут. Процессинг останавливается на 4 часа, банк получает штраф от регулятора в размере \$150,000 за нарушение непрерывности расчётов, а клиенты уходят к конкурентам.
Почему покупка дорогого оборудования без архитектурного анализа не защитила бизнес? Как архитектор должен был формализовать требования совета директоров в виде RTO (Recovery Time Objective), RPO (Recovery Point Objective), доступности 99.999% и независимых оптических трасс? Разберём на практических расчётах.
Роль сетевого архитектора и методология Cisco PPDIOO
Сетевой инженер или администратор фокусируется на вопросе: «Как настроить это оборудование прямо сейчас?» — он конфигурирует интерфейсы, настраивает списки доступа и устраняет инциденты. Сетевой архитектор (Network Architect) отвечает на вопросы: «Зачем мы строим именно такую архитектуру? Как она поддержит рост бизнеса через 3–5 лет? Сколько компания потеряет при отказе узла и сколько стоит устранение этого риска?».

Для системного проектирования и сопровождения сетей Cisco разработала методологию PPDIOO — шестифазный жизненный цикл корпоративной инфраструктуры:
- Prepare (Подготовка) — формирование бизнес-концепции. Архитектор определяет финансовые цели, окупаемость инвестиций (
ROI — Return on Investment) и совокупную стоимость владения (TCO — Total Cost of Ownership). Если сеть строится для онлайн-ритейлера, архитектор оценивает выручку с каждой минуты работы сети. - Plan (Планирование) — сбор исходных данных и аудит площадок. Оценивается существующая сеть (
As-Is), кабельная канализация, готовность стоек и электропитания (Site Readiness), профилируются потоки трафика и формируются системные ограничения (Constraints). - Design (Проектирование) — разработка детальной проектной документации. Архитектор создаёт два ключевых документа:
- HLD (High-Level Design) — концептуальный проект: выбор топологии модулей, протоколов маршрутизации, стратегии адресации, модели высокой доступности (HA) и матриц безопасности.
- LLD (Low-Level Design) — рабочая документация: кабельные журналы, номера стоек, распределение портов, шаблоны конфигураций и план приёмо-сдаточных испытаний NRFU (Network Ready for Use). - Implement (Внедрение) — монтаж, развёртывание и пуско-наладка по утверждённому LLD без нарушения текущих бизнес-процессов.
- Operate (Эксплуатация) — повседневное функционирование сети, управление конфигурациями, мониторинг соблюдения соглашений об уровне обслуживания (
SLA) силами NOC. - Optimize (Оптимизация) — проактивный поиск скрытых узких мест, анализ трендов загрузки каналов и плановый редизайн до наступления критических сбоев. Результаты оптимизации служат входом для нового витка фазы
Prepare.
| Фаза PPDIOO | Главная цель фазы | Входные данные | Итоговый артефакт | Роль сетевого архитектора |
|---|---|---|---|---|
Prepare | Обоснование инвестиций и бизнес-стратегии | Стратегия компании, бюджет, требования регуляторов | Бизнес-кейс, техническое задание | Ведущая (определение архитектурного вектора) |
Plan | Аудит текущего состояния и аудит рисков | Данные телеметрии As-Is, планы зданий, аудит каналов | Отчёт об аудите, матрица ограничений | Ведущая (выявление узких мест и рисков) |
Design | Разработка технического решения | Требования бизнеса, результаты фазы Plan | Проектные документы HLD, LLD, план NRFU | Исключительная (автор и валидатор проекта) |
Implement | Ввод сети в промышленную эксплуатацию | Комплект LLD, график технологических окон | Акт ввода в эксплуатацию, NRFU-тесты | Надзорная (авторский надзор изменений) |
Operate | Поддержание доступности сервисов Day-2 | Регламенты эксплуатации, мониторинг SLA | Отчёты об инцидентах, отчёты аптайма | Консультативная (разбор сложных аварий) |
Optimize | Предотвращение деградации и редизайн | Статистика NetFlow, тренды утилизации ресурсов | Предложения по модернизации сети | Ведущая (формирование стратегии расширения) |
Бизнес-требования против технических метрик
Главная ошибка начинающих дизайнеров — попытка защитить проект перед бизнесом техническим жаргоном: «Нам нужны коммутаторы Catalyst 9600 с поддержкой 100G и BFD». Финансовый директор слышит лишь запрос на сотни тысяч долларов расходов. Архитектор обязан разговаривать языком бизнес-показателей:
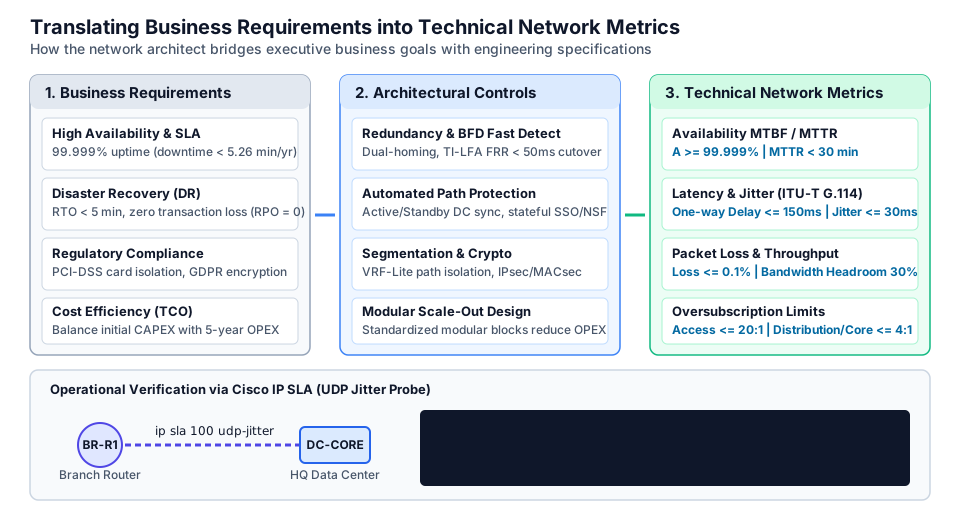
1. Непрерывность бизнеса (Business Continuity) и восстановление (Disaster Recovery)
- RTO (Recovery Time Objective) — целевое время восстановления. Максимально допустимый период, в течение которого сервис может оставаться недоступным после сбоя. Если для банковского процессинга
RTO = 5 минут, сеть обязана сходиться автоматически за секунды без ожидания приезда дежурного инженера. - RPO (Recovery Point Objective) — целевая точка восстановления. Максимальный объём данных во времени, который допустимо потерять при катастрофе. Если
RPO = 0, между основным и резервным ЦОД необходима синхронная репликация баз данных с круговой задержкой (RTT) строго менее5–10 мс.
2. Доступность по SLA (Availability) и закон «девяток»
Соглашение об уровне обслуживания (SLA — Service Level Agreement) юридически фиксирует процент времени, когда инфраструктура выполняет свои функции. Коэффициент готовности $A$ вычисляется через показатели среднего времени наработки на отказ (MTBF — Mean Time Between Failures) и среднего времени восстановления (MTTR — Mean Time To Repair):
$$A = \frac{\text{MTBF}}{\text{MTBF} + \text{MTTR}}$$
Каждая дополнительная «девятка» в SLA экспоненциально сокращает допустимое время аварийного простоя в год:
| Уровень доступности | Допустимый простой в год | Допустимый простой в месяц | Допустимый простой в неделю | Типичные сетевые требования |
|---|---|---|---|---|
99.0% (Две девятки) | 87.6 часа (3.65 дня) | 7.3 часа | 1.68 часа | Один маршрутизатор, один канал, ручное переключение |
99.9% (Три девятки) | 8.76 часа (525.6 мин) | 43.8 минуты | 10.1 минуты | Резервный канал, холодный резерв оборудования |
99.99% (Четыре девятки) | 52.56 минуты | 4.38 минуты | 1.01 минуты | Дублированные узлы, протоколы FHRP, сходимость IGP |
99.999% («Пять девяток») | 5.26 минуты (315 секунд) | 26.3 секунды | 6.05 секунды | Полное резервирование 2N, BFD/LFA сходимость < 50 мс, независимые вводы питания и оптики |
3. Финансовые ограничения: CAPEX против OPEX
Архитектор оценивает проект по формуле совокупной стоимости владения (TCO = CAPEX + N × OPEX):
- CAPEX (Capital Expenditures) — единовременные капитальные затраты: покупка шасси, оптических трансиверов, лицензий на программное обеспечение, монтаж кабельной системы.
- OPEX (Operational Expenditures) — регулярные операционные расходы: оплата каналов связи провайдеров, сервисные контракты технической поддержки (Cisco Smart Net Total Care), электропитание и охлаждение в ЦОД, зарплата инженеров эксплуатации.
Дешёвый коммутатор в закупке (низкий CAPEX) может иметь высокое энергопотребление, дорогие трансиверы и частые сбои ПО, что сделает суммарный OPEX за 5 лет в разы дороже качественного модульного шасси.
Разбор примера: расчёт бюджета простоя и финансового ущерба
Рассчитаем допустимый простой для финтех-компании и сопоставим стоимость сбоев с затратами на аппаратное резервирование ядра сети:
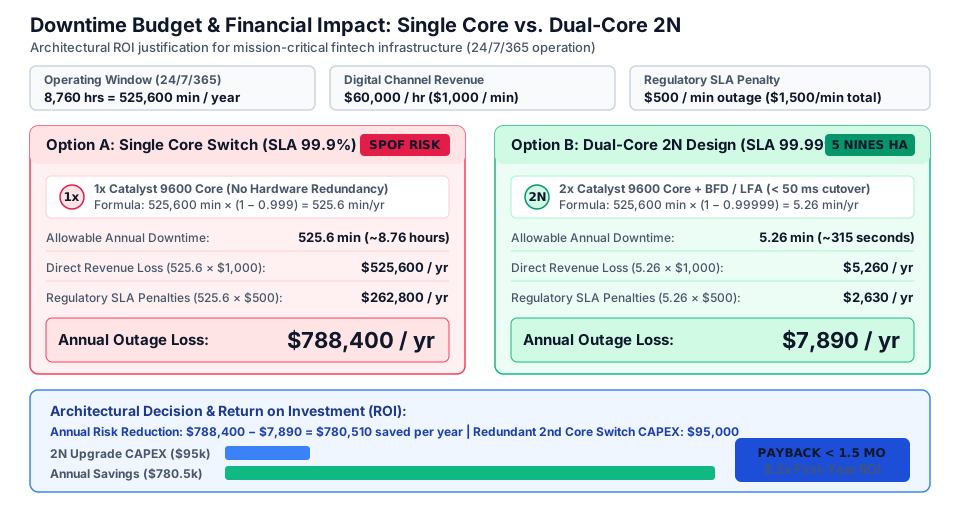
Исходные бизнес-параметры (Дано):
- Режим работы сервиса:
24/7/365=8,760 часов(525,600 минутв год). - Прямая выручка цифрового канала:
\$60,000 в час(\$1,000 в минуту). - Штраф регулятора за нарушение SLA:
\$25,000за инцидент +\$500за каждую минуту простоя (суммарная цена минуты аварии —\$1,500 / мин).
| Параметр проекта | Вариант A: Одиночное ядро (Single Core) | Вариант B: Дублированное ядро (Dual-Core 2N) |
|---|---|---|
| Целевой уровень доступности (SLA) | 99.9% («Три девятки») | 99.999% («Пять девяток») |
| Схема резервирования | 1× коммутатор ядра Catalyst 9600 (SPOF) | 2× коммутатора Catalyst 9600 + BFD / LFA < 50 мс |
| Допустимый простой в год | 525.6 минуты (~8.76 часа) | 5.26 минуты (~315 секунд) |
Прямая потеря выручки ($1,000/мин) | \$525,600 / год | \$5,260 / год |
Штрафные санкции по SLA ($500/мин) | \$262,800 / год | \$2,630 / год |
| Суммарный финансовый ущерб | \$788,400 / год | \$7,890 / год |
| Дополнительные затраты (CAPEX) | \$0 (базовая смета) | +\$95,000 (второе шасси + независимая оптика) |
Пошаговая математическая верификация расчёта для финансового комитета:
# Формула годового простоя: Downtime = 525600 мин * (1 - Availability)
Вариант A (Single Core 99.9%):
  Годовой простой: "525600 * (1 - 0.999) = 525.6 мин (8.76 ч)"
  Финансовый ущерб: "(525.6 * $1000) + (525.6 * $500) = $788,400 / год"

Вариант B (Dual-Core 2N 99.999%):
  Годовой простой: "525600 * (1 - 0.99999) = 5.26 мин (315 сек)"
  Финансовый ущерб: "(5.26 * $1000) + (5.26 * $500) = $7,890 / год"

Обоснование инвестиций (ROI):
  Предотвращённый ущерб: "$788,400 - $7,890 = $780,510 экономии в год"
  Стоимость резерва (CAPEX): "$95,000 (второй Catalyst 9600 + оптика)"
  Срок окупаемости (Payback): "$95,000 / ($780,510 / 12 мес) = 1.46 месяца (< 64 минут простоя)"
💡 Архитектурный вердикт: переход от
99.9%к99.999%сохраняет компании\$780,510в год. Капитальные затраты на второй коммутатор ядра (CAPEX = \$95,000) полностью окупаются менее чем за 1.5 месяца эксплуатации (или за первые 64 минуты предотвращённой аварии). Архитектура 2N математически и экономически оправдана.
Сбор исходных данных: Top-Down против Bottom-Up
В сетевом дизайне существуют две диаметрально противоположные стратегии сбора требований:
- Подход снизу вверх (Bottom-Up): инженер начинает с физического уровня: «У нас на складе есть пять старых коммутаторов и кабель Cat5e. Давайте объединим их и пустим поверх трафик». Результат — узкие места, неожиданная деградация критических сервисов и необходимость полной перестройки сети через полгода.
- Подход сверху вниз (Top-Down): архитектор начинает с верхнего уровня модели OSI — приложений и бизнес-процессов:
- Шаг 1: Какие приложения работают в сети (VoIP, видеоконференции, ERP, репликация баз данных)?
- Шаг 2: Каковы требования каждого приложения к пропускной способности, задержке, джиттеру и потерям?
- Шаг 3: Где расположены клиенты и серверы (матрица потоков трафика)?
- Шаг 4: Какие логические протоколы L3/L2 и механизмы QoS обеспечат эти требования?
- Шаг 5: Какое физическое оборудование и топология требуются для реализации?
| Критерий сравнения | Подход Top-Down (Рекомендуемый Cisco) | Подход Bottom-Up (Устаревший) |
|---|---|---|
| Начальная точка | Бизнес-цели и требования приложений | Существующее оборудование и кабели |
| Масштабируемость | Запас роста на 3–5 лет заложен в архитектуру | Ограничена характеристиками старых шасси |
| Качество для критичных сервисов | Гарантировано проектными метриками QoS и SLA | Случайное, часто возникают коллизии и дропы |
| Бюджетная эффективность | Инвестиции идут точно в критические узлы | Деньги тратятся на латание дыр и переделки |
| Когда применим | Проектирование новых сетей и масштабные модернизации | Мелкие локальные доработки без изменения структуры |
Матрица трафика и архитектурные ограничения (Design Constraints)
В процессе аудита архитектор формирует матрицу трафика приложений и каталог проектных ограничений:
- Технические ограничения: существующая оптика (одномод OS2 против многомода OM1/OM3), максимальная длина кабельных трасс (100 м для меди), пределы мощности ИБП в серверных стойках.
- Организационные ограничения: требования службы безопасности (изоляция сегментов банкоматов и офисной сети), регламенты технологических окон (работы только с 02:00 до 05:00 в воскресенье).
- Бюджетные ограничения: жёсткий лимит CAPEX на текущий финансовый квартал.
Разбор примера: матрица требований и валидация через Cisco IP SLA
Сведём бизнес-требования приложений банка в техническую матрицу спецификаций QoS и подтвердим их реальными измерениями с помощью технологии Cisco IP SLA:
| Приложение | Протокол и порт | Полоса на поток | Задержка (One-Way) | Джиттер (Max) | Потери (Max) | Класс QoS (DSCP) |
|---|---|---|---|---|---|---|
| IP-телефония (VoIP) | UDP / RTP | 80 Кбит/с (G.711) | <= 150 мс | <= 30 мс | <= 1.0% | EF (DSCP 46) |
| Видеоконференции (HD) | UDP / RTP | 2.5 Мбит/с | <= 150 мс | <= 30 мс | <= 0.5% | AF41 (DSCP 34) |
| Банковский процессинг | TCP / 443 | 128 Кбит/с | <= 200 мс | N/A | <= 0.1% | AF21 (DSCP 18) |
| Репликация БД (DR) | TCP / 1521 | 500 Мбит/с (burst) | <= 10 мс (RTT) | <= 2 мс | 0.0% | AF11 (DSCP 10) |
| Гостевой Wi-Fi | TCP/UDP | Best-Effort | <= 400 мс | N/A | <= 3.0% | DF (DSCP 0) |
Для непрерывного инструментального контроля этих метрик на маршрутизаторе филиала настраивается зонд Cisco IP SLA UDP Jitter в сторону дата-центра:
BR-R1(config)# ip sla 100
BR-R1(config-ip-sla)# type udp-jitter 10.100.1.1 50000 num-packets 100 interval 20
BR-R1(config-ip-sla-jitter)# request-data-size 160
BR-R1(config-ip-sla-jitter)# frequency 60
BR-R1(config-ip-sla-jitter)# threshold 150
BR-R1(config-ip-sla-jitter)# tos 184
BR-R1(config-ip-sla-jitter)# exit
BR-R1(config)# ip sla schedule 100 life forever start-time now

BR-R1# show ip sla statistics 100
IPSLAs Latest Operation Statistics
IPSLA operation id: 100
Type of operation: udp-jitter
Latest operation start time: 10:14:22 UTC
Latest operation return code: OK
RTT Values:
  Number of RTT: 100
  RTT Min/Avg/Max: 22/28/35 milliseconds
Latency one-way values:
  Number of Latency one-way Samples: 100
  Source to Destination Latency Min/Avg/Max: 11/14/18 milliseconds
  Destination to Source Latency Min/Avg/Max: 11/14/17 milliseconds
Jitter values:
  Source to Destination Jitter Min/Avg/Max: 1/2/4 milliseconds
  Destination to Source Jitter Min/Avg/Max: 1/2/3 milliseconds
Packet Loss values:
  Packet Loss from Source to Destination: 0
  Packet Loss from Destination to Source: 0
  Out of Sequence: 0, Late Arrivals: 0
SLA Threshold Over-Occurrences: 0
Анализ вывода команды show ip sla statistics 100:
Source to Destination Latency Avg: 14 ms— односторонняя задержка в 10 раз лучше критического предела150 мс;Jitter Avg: 2 ms— вариация задержки ничтожно мала и укладывается в норматив30 мс;Packet Loss: 0— зафиксировано нулевое число потерянных пакетов;- Сетевой канал полностью удовлетворяет проектным требованиям для голоса и критических транзакций.
Что может сломаться и как это найти
| Ошибка проектирования / Симптом | Последствие для сети | Как спроектировать правильно |
|---|---|---|
| Проектирование по схеме Bottom-Up без матрицы трафика | В пиковые часы видеоконференции и вызовы VoIP прерываются из-за нехватки полосы и перегрузки буферов | Начинать аудит с приложений (Top-Down), вычислять пиковую пропускную способность и внедрять политики QoS |
Оценка доступности 99.999% без учёта времени сходимости | При обрыве оптического кабеля стандартные таймеры протокола сходятся 30–45 секунд, мгновенно исчерпывая годовой лимит простоя | Внедрять протокол BFD (<= 150 мс) совместно с технологией Loop-Free Alternate (LFA / TI-LFA < 50 мс) |
| Игнорирование единой точки отказа (SPOF) во вспомогательной инфраструктуре | Пожар или обесточивание одной серверной выводит из строя оба дублированных маршрутизатора | Проектировать независимые трассы оптики, раздельные вводы электропитания (АВР, ДГУ) и территориально разнесённые узлы |
| Выбор оборудования по минимальному CAPEX без оценки стоимости владения | Через 3 года затраты на электропитание, охлаждение, дорогие трансиверы и внеплановые ремонты втрое превышают экономию | Рассчитывать совокупную стоимость владения TCO на 3–5 лет (CAPEX + N * OPEX) перед утверждением спецификации |
⚠️ Типичная ошибка архитектора: обещать бизнесу доступность «пяти девяток» (
99.999%), установив два дорогих маршрутизатора в одной стойке, но забыв, что оба кабеля провайдеров заведены в здание через одну трубу, а оба блока питания включены в один автоматический выключатель. Любая авария в точке общего отказа (SPOF) обнуляет все инвестиции в резервирование протоколов.
Практика
- Предскажите. Оператор связи предлагает компании SLA доступности интернет-канала на уровне
99.95%. Какое максимальное суммарное время аварийного простоя (в минутах) допустимо по этому договору за один календарный месяц (30 дней)? - Проверьте. Маршрутизатор по паспорту имеет показатель среднего времени наработки на отказ
MTBF = 100,000 часов. Нормативное среднее время замены и восстановления инженерами сервисного центраMTTR = 5 часов. Рассчитайте коэффициент доступности этого устройства и определите, достаточно ли одного такого маршрутизатора для обеспечения SLA99.999%? - Объясните. Почему при проектировании распределённой корпоративной сети аудит методом Top-Down всегда начинается с интервью с владельцами бизнес-приложений, а не со сбора конфигураций существующих коммутаторов?
- Измените. В приведённой конфигурации зонда
ip sla 100пороговое значениеthresholdнастроено на150 мс. Измените конфигурацию для финансового канала репликации между ЦОД, где максимальная допустимая задержка в одну сторону составляет15 мс, а проверка должна выполняться каждые10 секунд. - Сделайте сами ⭐. Спроектируйте архитектурные требования для телемедицинской сети регионального госпиталя: подключено
50операционных блоков с трансляцией эндоскопических операций в 4K (25 Мбит/споток на зал, максимальная задержка50 мс, потеря пакетов0%). Сформулируйте требования к SLA, рассчитайте суммарную полосу, определите критичность RTO/RPO и опишите механизмы резервирования для устранения SPOF.
Самопроверка
Вопрос 1. В чём принципиальная архитектурная разница между показателями RTO (Recovery Time Objective) и RPO (Recovery Point Objective), и с помощью каких сетевых механизмов архитектор обеспечивает выполнение каждого из них?
- Разбор: RTO определяет максимальное время простоя сервиса после аварии (как быстро сеть должна восстановить связность). Архитектор обеспечивает RTO аппаратным дублированием компонентов, отказоустойчивыми протоколами маршрутизации с быстродействующей сходимостью (
BFD,LFA FRR) и кластеризацией шлюзов (FHRP,StackWise Virtual). RPO определяет максимальный объём данных, который допустимо потерять во времени. ВыполнениеRPO = 0зависит от способности сети гарантировать сверхнизкую задержку (RTT < 5–10 мс), стабильный джиттер и нулевые потери пакетов для непрерывной синхронной репликации баз данных между дата-центрами.
Вопрос 2. В выводе команды show ip sla statistics 100 сетевой инженер обнаружил следующие параметры: RTT Avg: 185 ms, Source to Destination Latency Avg: 94 ms, Source to Destination Jitter Max: 48 ms, Packet Loss: 12. Соответствует ли этот канал корпоративному стандарту для голосового трафика VoIP?
- Разбор: Канал грубо нарушает стандарты качества голосовой связи. Хотя односторонняя задержка
94 мсформально укладывается в норматив ITU-T G.114 (<= 150 мс), максимальный джиттер48 мспревышает порог30 мс(что вызовет опустошение буфера джиттера IP-телефона и роботизацию речи), а наличие12потерянных пакетов приведет к щелчкам и выпадению целых слогов в разговоре.
Ответы к практике:
- В 30 днях содержится
30 * 24 * 60 = 43,200 минут. При доступности99.95%допустимый простой составляет:43,200 * (1 - 0.9995) = 43,200 * 0.0005 = 21.6 минутыв месяц. - $A = \frac{100,000}{100,000 + 5} = \frac{100,000}{100,005} \approx 0.99995$ (
99.995%). Это соответствует четырём девяткам (простой около 26 минут в год). Одиночное устройство ни при каких условиях не обеспечивает требования SLA99.999%(лимит 5.26 минут в год), поэтому необходима дублированная архитектура с автоматическим переключением. - Сеть существует исключительно для передачи трафика бизнес-приложений. Начиная с конфигураций коммутаторов (Bottom-Up), инженер видит лишь текущие порты, но не знает, какие сервисы планируется запустить через год, какова критичность транзакций и где узкие места бизнес-процессов. Подход Top-Down позволяет сначала выявить критические требования, а затем построить инфраструктуру, оптимальную по функциональности и бюджету.
- Для канала репликации ЦОД зонд конфигурируется с уменьшенным интервалом и ужесточённым порогом:
ip sla 100
 threshold 15
frequency 10- Проектные параметры телемедицинской сети:
- Суммарная полоса видеопотоков:50 залов * 25 Мбит/с = 1.25 Гбит/сполезной нагрузки. С учётом служебного трафика, телеметрии оборудования и запаса роста 30% суммарная ёмкость ядра должна составлять не менее2 × 10 Гбит/с.
- SLA доступности:99.999%(отказ связи во время операции угрожает жизни пациента). RTO= 0(мгновенное переключение при обрыве), RPO= 0.
- Устранение SPOF: каждый операционный зал подключается двумя независимыми кабельными трассами к двум независимым коммутаторам доступа, коммутаторы распределения работают в кластере с аплинками40Gк ядру, электропитание организуется по схеме 2N (два независимых ИБП и дизель-генератор), трафик маркируется наивысшим приоритетомDSCP AF41/EF.
Повторение и критерий перехода
Вы готовы идти дальше, если без подсказки можете:
- назвать все 6 фаз жизненного цикла сети Cisco PPDIOO и объяснить, на каких этапах архитектор играет ключевую роль;
- объяснить разницу между RTO, RPO, MTBF, MTTR и перевести требование непрерывности бизнеса в технические метрики сети;
- по формуле рассчитать допустимый простой для любого процента SLA и обосновать бизнесу окупаемость дублированного оборудования;
- объяснить руководству компании, почему проектирование Top-Down защищает бюджет от нерациональных расходов;
- по выводу
show ip sla statisticsопределить качество канала и готовность к передаче чувствительного трафика.
Вопрос на повторение (база CCNA): почему для передачи трафика реального времени (голос и видео) используется транспортный протокол UDP, а не надёжный TCP с подтверждением доставки?
💡 Смежные уроки в других курсах: для детального разбора команд настройки и траблшутинга см. Иерархический дизайн кампуса: Access, Distribution, Core и расчёт переподписки.
Стандарты и источники
- Cisco Validated Design (CVD) — Enterprise Network Design Principles and Methodologies.
- Cisco Exam Blueprint — 300-420 ENSLD v1.1/v1.2, раздел
1.1 Translate business requirements into technical network designs (SLA, budget, scale, compliance). - ITU-T Recommendation G.114 — One-way transmission time for voice and multimedia applications.
- IETF RFC 2544 — Benchmarking Methodology for Network Interconnect Devices.
